Cara memakai pdf24 OCR PDF dalam 4 langkah
- Buka scan. Pilih PDF hasil scan atau foto halaman (JPG, PNG, WebP), atau letakkan di kotak.
- Periksa bahasanya. Pilih bahasa teks dari 11 pilihan; daftar dimulai dari bahasa halaman ini.
- Pilih hasilnya. PDF yang bisa dicari mempertahankan halaman dan menambahkan teks tersembunyi; Teks biasa hanya menyimpan kata-katanya sebagai file .txt.
- Jalankan dan unduh. Tekan tombol, tunggu sementara setiap halaman dikenali, lalu simpan file -ocr.pdf atau .txt.
Apa yang diubah pdf24 OCR PDF pada file hasil scan?
pdf24 OCR PDF membiarkan setiap halaman asli tidak tersentuh dan menambahkan lapisan tak terlihat berisi kata-kata hasil pengenalan yang diletakkan di atas huruf yang sesuai. Penampil lalu memungkinkan Anda mencari, memilih, dan menyalin teks, sementara halaman tetap menampilkan scan aslinya. Kata dengan tingkat keyakinan sangat rendah dihilangkan, bukan ditebak.
“Optical character recognition (OCR) or optical character reader is the electronic or mechanical conversion of images of typed, handwritten or printed text into machine-encoded text (Pengenalan karakter optik (OCR) adalah konversi elektronik atau mekanis gambar teks ketikan, tulisan tangan, atau cetakan menjadi teks yang dapat dibaca mesin)”
| File | Hasil | Kata | Sebelum → sesudah | Waktu |
|---|---|---|---|---|
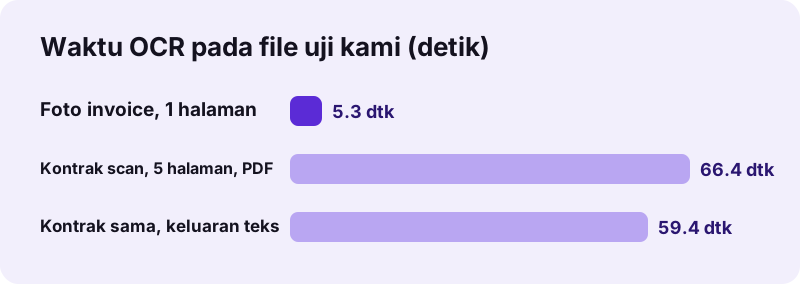
| Foto invoice (PNG, 1 halaman) | PDF yang bisa dicari | 54 | 72 KB → 105 KB | 5,3 dtk |
| Kontrak scan (PDF, 5 halaman) | PDF yang bisa dicari | 2.575 | 2,46 MB → 2,60 MB | 66,4 dtk |
| Kontrak yang sama | Teks biasa | sekitar 2.591 | → 14 KB .txt | 59,4 dtk |
Akurasi pdf24 OCR PDF pada scan yang bersih
Kami memeriksa keluaran teks pdf24 OCR PDF dari kontrak 5 halaman kata demi kata terhadap kata-kata dokumen asli: seluruh 2.565 kata beralfabet adalah kata asli dari sumbernya, tanpa satu pun yang salah baca. Sebelum OCR, pencarian thirty menemukan 0 hasil di scan; sesudah OCR pencarian yang sama menemukan 150. Foto invoice kembali sebagai teks persisnya, termasuk jumlah seperti 319.70.
pdf24 OCR PDF di ponsel
pdf24 OCR PDF berjalan juga di ponsel, tetapi pekerjaannya berat: setiap halaman dirender sekitar 300 dpi dan dianalisis oleh mesin pengenalan di perangkat. Perkirakan ponsel lebih lama daripada 13 detik per halaman di laptop kami, biarkan layar menyala, dan mulailah dengan beberapa halaman.
pdf24 OCR PDF di komputer
Di komputer, scan panjang praktis dikerjakan: kontrak 5 halaman kami memakan sedikit lebih dari semenit. Baris kemajuan menunjukkan halaman mana yang sedang dibaca. Proses pertama dalam satu sesi juga mengunduh data bahasa satu kali, itulah sebabnya foto 1 halaman kami memakan 5,3 detik.
Tips pdf24 OCR PDF untuk hasil lebih baik
Scan pada 300 dpi, jaga halaman tetap lurus, dan gunakan pembersihan Dokumen atau Hitam putih di Scan ke PDF untuk foto ponsel. Kontras yang bersih dan garis yang lurus lebih penting bagi pengenalan daripada warna.
Bahasa apa saja yang dikenali pdf24 OCR PDF?
pdf24 OCR PDF mengenali 11 bahasa: Inggris, Prancis, Spanyol, Portugis, Jerman, Italia, Rusia, Arab, Indonesia, Turki, dan Vietnam. Pilih bahasa tempat dokumen ditulis; daftar dimulai dari bahasa halaman yang sedang Anda buka. Pengaturan bahasa yang salah terutama merugikan aksen dan huruf khusus.
| Bahasa | Aksara | Catatan |
|---|---|---|
| Inggris, Prancis, Spanyol, Portugis, Jerman, Italia, Indonesia, Turki, Vietnam | Latin dengan aksen | Pilih bahasa yang tepat untuk aksennya (é, ß, ş, ơ) |
| Rusia | Sirilik | Kata berhuruf Latin dalam teks dibaca kurang andal |
| Arab | Arab, kanan ke kiri | Font Arab disematkan untuk lapisan teks |
pdf24 OCR PDF dengan dokumen berbahasa campuran
Satu bahasa dipakai per proses. Untuk surat berbahasa Prancis dengan nama berbahasa Inggris, pilih Prancis: nama berhuruf Latin tetap dikenali. Untuk dokumen dengan dua aksara, seperti Arab dan Inggris, jalankan bahasa yang dominan; aksara lainnya mungkin tidak lengkap.
Apakah pdf24 OCR PDF privat jika mengunduh mesin?
pdf24 OCR PDF mengunduh mesin pengenalan dan data bahasa dari pustaka kode publik saat pertama dipakai, tetapi file Anda tidak pernah bergerak ke arah sebaliknya: halaman dibaca, dirender, dan dikenali di perangkat Anda. Baris hasil kami menyatakan 0 byte diunggah pada setiap proses OCR, termasuk kontrak 2,46 MB.
Mesinnya adalah Tesseract, dikompilasi agar berjalan di dalam browser. Mengunduh kode dan kamus sama seperti memuat font; tidak ada hal tentang dokumen Anda dalam permintaan itu. File API di MDN menjelaskan bagaimana halaman membaca file lokal tanpa mengirimkannya.
“Tesseract is an optical character recognition engine for various operating systems. It is free software, released under the Apache License. (Tesseract adalah mesin pengenalan karakter optik untuk berbagai sistem operasi. Ini perangkat lunak bebas, dirilis di bawah Lisensi Apache.)”
Mengapa pdf24 OCR PDF menemukan kata yang salah atau tidak ada?
pdf24 OCR PDF bergantung pada apa yang ditampilkan halaman. Foto buram, cetakan kecil, tulisan tangan, stempel tebal, dan pengaturan bahasa yang salah semuanya menurunkan akurasi. Gambar tanpa teks bahkan bisa menghasilkan kata sampah: halaman uji kami berisi bentuk warna-warni acak mengembalikan 457 kata tak bermakna. Scan lurus dan bersih dari teks cetak memberi hasil terbaik.
| Masalah | Solusi |
|---|---|
| Tidak ada teks yang dikenali | Periksa bahasanya, dan pastikan halaman tidak terbalik; putar dengan Putar halaman PDF |
| Banyak huruf salah | Scan ulang pada 300 dpi atau bersihkan foto dengan Scan ke PDF |
| Tulisan tangan tidak terbaca | Mesin dilatih pada cetakan; tulisan tangan tidak didukung |
| Kata sampah pada foto atau grafik | Hapus di keluaran teks, atau OCR hanya halaman teks |
| File sudah punya teks | OCR tidak perlu: gunakan Salin teks PDF atau Cari di PDF |
pdf24 OCR PDF dan langkah berikutnya
PDF yang bisa dicari dari pdf24 OCR PDF membuka jalan ke alat teks lainnya. Langkah berikutnya yang umum setelah OCR:
- Temukan setiap penyebutan nama atau jumlah dengan Cari di PDF.
- Salin seluruh teks dengan Salin teks PDF.
- Ubah scan menjadi dokumen yang bisa diedit dengan PDF ke Word.
- Bandingkan dua versi scan dengan Bandingkan PDF, setelah OCR pada keduanya.
- Kecilkan hasilnya dengan Kompres PDF jika harus muat di email.
pdf24 OCR PDF: pertanyaan yang sering diajukan
Apakah pdf24 OCR PDF gratis?
Ya. OCR di pdf24tools gratis, tanpa akun, tanpa watermark, dan tanpa batas halaman. Pengenalan berjalan di browser pada perangkat Anda sendiri, jadi tidak ada waktu server yang perlu ditagihkan. Dokumen panjang hanya memakan waktu lebih lama, sekitar 13 detik per halaman di laptop kami.
Apakah pdf24 OCR PDF mengunggah scan saya?
Tidak. Halaman mengunduh mesin pengenalan dan data bahasa satu kali, tetapi file Anda tidak pernah dikirim: baris hasil kami menyatakan 0 byte diunggah pada setiap proses. Halaman dirender dan dikenali di perangkat Anda, dan tidak ada yang disimpan setelah Anda menutup tab.
Berapa lama pdf24 OCR PDF bekerja?
Di laptop Windows kami, sekitar 13 detik per halaman: 66,4 detik untuk kontrak scan 5 halaman dan 5,3 detik untuk foto invoice 1 halaman, termasuk unduhan data bahasa satu kali. Ponsel lebih lambat. Baris kemajuan menunjukkan halaman mana yang sedang dikenali.
Bisakah pdf24 OCR PDF membaca tulisan tangan?
Tidak dengan andal. Mesinnya dilatih pada teks cetak, sehingga catatan tulisan tangan biasanya keluar sebagai huruf yang salah atau dilewati. Formulir cetak dengan jawaban tulisan tangan berfungsi untuk bagian cetaknya; ketik sendiri jawaban tulisan tangan itu jika harus bisa dicari.
Apakah pdf24 OCR PDF mengubah tampilan scan saya?
Tidak. Halaman asli tetap persis seperti semula; kata-kata hasil pengenalan ditambahkan sebagai teks tak terlihat di atas huruf yang sesuai. Hanya ukuran file yang bertambah sedikit, dari 2,46 MB menjadi 2,60 MB untuk kontrak 5 halaman kami, terutama karena font yang disematkan.
Bisakah pdf24 OCR PDF menyimpan teks biasa?
Bisa. Pilih Teks biasa (.txt) sebagai hasil untuk mendapat kata-kata hasil pengenalan saja, dengan baris --- n --- di antara halaman. Kontrak 5 halaman kami menghasilkan file teks 14 KB berisi sekitar 2.591 kata, siap ditempel ke dokumen atau alat terjemahan.
File apa yang diterima pdf24 OCR PDF?
PDF hasil scan dan gambar tunggal yang bisa dibuka browser Anda, seperti JPG, PNG, dan WebP. PDF dibaca halaman demi halaman pada sekitar 300 dpi; satu gambar menjadi satu halaman. Untuk beberapa foto, gabungkan dulu dengan Scan ke PDF, lalu jalankan OCR pada PDF itu.
Seberapa akurat pdf24 OCR PDF?
Pada scan teks cetak yang bersih dan lurus, akurasinya sangat tinggi: seluruh 2.565 kata beralfabet dari kontrak 5 halaman kami cocok dengan sumbernya. Akurasi turun karena buram, cetakan kecil, halaman miring, stempel, dan pengaturan bahasa yang salah, dan gambar tanpa teks bisa menghasilkan kata sampah.
Bisakah pdf24 OCR PDF mengenali bahasa Arab?
Bisa. Pilih Arab sebagai bahasa; lapisan teks ditulis dengan font Arab yang disematkan. Pengenalan bahasa Arab lebih sensitif terhadap kualitas scan daripada teks Latin, sehingga scan 300 dpi yang tajam lebih penting lagi. Halaman campuran Arab dan Inggris mungkin kehilangan sebagian aksara yang kedua.
Mengapa pdf24 OCR PDF tidak menemukan teks?
Biasanya bahasanya salah, halamannya terbalik atau menyamping, atau scan terlalu buram. Putar halaman lebih dulu, pilih bahasa yang benar, dan coba lagi. Jika PDF sudah punya lapisan teks, OCR tidak diperlukan: Salin teks PDF membacanya langsung tanpa proses pengenalan yang lama, sehingga hasilnya lebih cepat dan lebih akurat.
Bisakah saya memakai pdf24 OCR PDF di ponsel?
Bisa, di Chrome, Safari, Edge, dan Firefox terbaru. OCR menuntut tenaga, jadi ponsel lebih lama daripada komputer dan layarnya harus tetap menyala. Mulailah dengan beberapa halaman; untuk scan panjang, komputer adalah pilihan yang lebih nyaman dan biasanya selesai jauh lebih cepat tanpa menguras baterai.
Siapa yang membuat alat pdf24 OCR PDF?
Tim pdf24tools yang membuatnya. pdf24tools adalah situs web independen dan tidak berafiliasi dengan PDF24 atau Geek Software GmbH. Halaman OCR kami memakai mesin sumber terbuka Tesseract di dalam browser Anda; halaman ini menggambarkannya hanya dari uji kami sendiri dengan file kami sendiri.
Alat dan panduan pdf24 OCR PDF lainnya
pdf24 OCR PDF: sumber
- Optical character recognition — Wikipedia
- Tesseract (software) — Wikipedia
- File API — MDN Web Docs