Come usare pdf24 ocr pdf in 4 passaggi
- Apri la scansione. Scegli un PDF scansionato o la foto di una pagina (JPG, PNG, WebP), oppure trascinala sulla casella.
- Controlla la lingua. Scegli la lingua del testo tra 11 opzioni; parte dalla lingua di questa pagina.
- Scegli il risultato. PDF ricercabile mantiene le pagine e aggiunge testo nascosto; Testo semplice salva solo le parole in un file .txt.
- Avvia e scarica. Premi il pulsante, attendi mentre ogni pagina viene riconosciuta, poi salva il file -ocr.pdf o .txt.
Cosa cambia pdf24 ocr pdf in un file scansionato?
pdf24 ocr pdf lascia intatta ogni pagina originale e aggiunge un livello invisibile di parole riconosciute, posizionate sopra le lettere corrispondenti. I visualizzatori permettono allora di cercare, selezionare e copiare il testo, mentre la pagina mostra ancora la scansione originale. Le parole riconosciute con confidenza molto bassa vengono omesse invece di essere indovinate.
“Optical character recognition (OCR) or optical character reader is the electronic or mechanical conversion of images of typed, handwritten or printed text into machine-encoded text (Il riconoscimento ottico dei caratteri, OCR, è la conversione elettronica o meccanica di immagini di testo dattiloscritto, manoscritto o stampato in testo codificato per la macchina)”
| File | Risultato | Parole | Prima → dopo | Tempo |
|---|---|---|---|---|
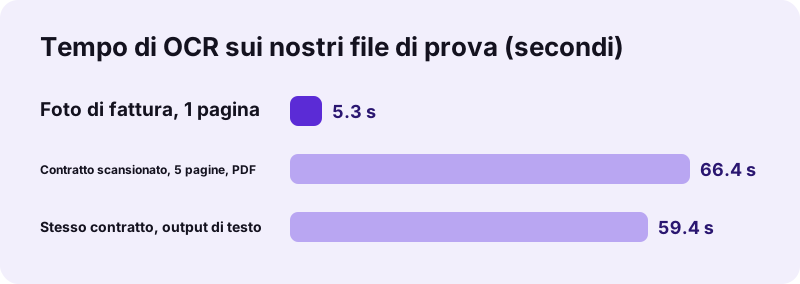
| Foto di fattura (PNG, 1 pagina) | PDF ricercabile | 54 | 72 KB → 105 KB | 5,3 s |
| Contratto scansionato (PDF, 5 pagine) | PDF ricercabile | 2.575 | 2,46 MB → 2,60 MB | 66,4 s |
| Stesso contratto | Testo semplice | circa 2.591 | → .txt da 14 KB | 59,4 s |
pdf24 ocr pdf: accuratezza su una scansione pulita
Abbiamo controllato parola per parola l'output di testo di pdf24 ocr pdf del contratto di 5 pagine rispetto alle parole del documento originale: tutte le 2.565 parole alfabetiche erano parole reali della fonte, senza alcuna parola letta male. Prima dell'OCR, una ricerca di thirty trovava 0 corrispondenze nella scansione; dopo l'OCR la stessa ricerca ne ha trovate 150. La foto della fattura è tornata con il suo testo esatto, compresi importi come 319,70.
pdf24 ocr pdf su un telefono
pdf24 ocr pdf gira anche sui telefoni, ma è un lavoro pesante: ogni pagina viene renderizzata a circa 300 dpi e analizzata dal motore di riconoscimento sul dispositivo. Aspettati che un telefono impieghi più dei 13 secondi a pagina del nostro portatile, tieni lo schermo acceso e comincia con poche pagine.
pdf24 ocr pdf su un computer
Su un computer le scansioni lunghe sono praticabili: il nostro contratto di 5 pagine ha richiesto poco più di un minuto. La riga di avanzamento mostra quale pagina viene letta. La prima esecuzione di una sessione scarica anche una volta i dati della lingua, ed è per questo che la nostra foto di 1 pagina ha richiesto 5,3 secondi.
pdf24 ocr pdf, consiglio per risultati migliori
Scansiona a 300 dpi, tieni le pagine dritte e usa la pulizia Documento o Bianco e nero di Scansiona in PDF per le foto da telefono. Un buon contrasto e righe dritte contano per il riconoscimento più del colore.
Quali lingue riconosce pdf24 ocr pdf?
pdf24 ocr pdf riconosce 11 lingue: inglese, francese, spagnolo, portoghese, tedesco, italiano, russo, arabo, indonesiano, turco e vietnamita. Scegli la lingua in cui è scritto il documento; l'elenco parte dalla lingua della pagina in cui ti trovi. Un'impostazione di lingua sbagliata costa soprattutto accenti e lettere speciali.
| Lingua | Scrittura | Nota |
|---|---|---|
| Inglese, francese, spagnolo, portoghese, tedesco, italiano, indonesiano, turco, vietnamita | Latina con accenti | Scegli la lingua esatta per i suoi accenti (é, ß, ş, ơ) |
| Russo | Cirillica | Le parole in lettere latine nel testo sono lette con minore affidabilità |
| Arabo | Araba, da destra a sinistra | Per il livello di testo viene incorporato un carattere arabo |
pdf24 ocr pdf con documenti in più lingue
Per ogni esecuzione si usa una lingua. Per una lettera francese con nomi inglesi, scegli il francese: i nomi in lettere latine vengono comunque riconosciuti. Per documenti in due scritture, come arabo e inglese, esegui la lingua dominante; l'altra scrittura può uscire incompleta.
pdf24 ocr pdf è privato se scarica un motore?
pdf24 ocr pdf scarica al primo utilizzo il motore di riconoscimento e i dati della lingua da una libreria di codice pubblica, ma il tuo file non viaggia mai in senso inverso: le pagine vengono lette, renderizzate e riconosciute sul tuo dispositivo. Ogni esecuzione OCR indicava 0 byte caricati, anche il contratto da 2,46 MB.
Il motore è Tesseract, compilato per girare dentro il browser. Scaricare codice e dizionari è come caricare un carattere; in quelle richieste non c'è nulla del tuo documento. La File API su MDN spiega come una pagina legge un file locale senza inviarlo.
“Tesseract is an optical character recognition engine for various operating systems. It is free software, released under the Apache License. (Tesseract è un motore di riconoscimento ottico dei caratteri per vari sistemi operativi. È software libero, rilasciato con la licenza Apache.)”
Perché pdf24 ocr pdf trova parole sbagliate o nessuna parola?
pdf24 ocr pdf dipende da ciò che mostra la pagina. Foto sfocate, caratteri minuscoli, scrittura a mano, timbri pesanti e l'impostazione di lingua sbagliata riducono l'accuratezza. Le immagini senza testo possono produrre parole spazzatura: una pagina di forme colorate ne ha restituite 457. Le scansioni pulite di testo stampato danno i migliori risultati.
| Problema | Rimedio |
|---|---|
| Nessun testo riconosciuto | Controlla la lingua e assicurati che la pagina non sia capovolta; ruotala con Ruota pagine PDF |
| Molte lettere sbagliate | Riscansiona a 300 dpi o pulisci la foto con Scansiona in PDF |
| Scrittura a mano non letta | Il motore è addestrato sulla stampa; la scrittura a mano non è supportata |
| Parole spazzatura su foto o grafici | Eliminale nell'output di testo, oppure esegui l'OCR solo sulle pagine di testo |
| Il file ha già del testo | Non serve l'OCR: usa Copia da PDF o Cerca nel PDF |
pdf24 ocr pdf e cosa fare dopo
Un PDF ricercabile creato con pdf24 ocr pdf apre la porta agli altri strumenti di testo. Passaggi tipici dopo l'OCR:
- Trova ogni menzione di un nome o di un importo con Cerca nel PDF.
- Copia tutto il testo con Copia da PDF.
- Trasforma la scansione in un documento modificabile con PDF in Word.
- Confronta due versioni scansionate con Confronta PDF, dopo l'OCR su entrambe.
- Riduci il risultato con Comprimi PDF se deve stare in un'email.
pdf24 OCR PDF: domande frequenti
pdf24 ocr pdf è gratis?
Sì. L'OCR su pdf24tools è gratis, senza account, senza filigrana e senza limite di pagine. Il riconoscimento gira nel browser sul tuo dispositivo, quindi non c'è tempo di server da addebitare. I documenti lunghi richiedono semplicemente più tempo, circa 13 secondi a pagina sul nostro portatile.
pdf24 ocr pdf carica la mia scansione?
No. La pagina scarica una volta il motore di riconoscimento e i dati della lingua, ma il tuo file non viene mai inviato: le nostre righe del risultato indicavano 0 byte caricati a ogni esecuzione. Le pagine vengono renderizzate e riconosciute sul tuo dispositivo e nulla resta dopo che chiudi la scheda.
Quanto tempo richiede pdf24 ocr pdf?
Sul nostro portatile Windows circa 13 secondi a pagina: 66,4 secondi per un contratto scansionato di 5 pagine e 5,3 secondi per la foto di una fattura di 1 pagina, compreso il download una tantum della lingua. I telefoni sono più lenti. La riga di avanzamento mostra quale pagina viene riconosciuta.
pdf24 ocr pdf può leggere la scrittura a mano?
Non in modo affidabile. Il motore è addestrato sul testo stampato, quindi gli appunti manoscritti di solito escono come lettere sbagliate o vengono saltati. I moduli stampati con risposte a mano funzionano per la parte stampata; digita tu le risposte manoscritte se devono essere ricercabili.
pdf24 ocr pdf cambia l'aspetto della mia scansione?
No. Le pagine originali restano esattamente com'erano; le parole riconosciute vengono aggiunte come testo invisibile sopra le lettere corrispondenti. Cresce solo un poco la dimensione del file, da 2,46 MB a 2,60 MB per il nostro contratto di 5 pagine, soprattutto per via del carattere incorporato.
pdf24 ocr pdf può salvare testo semplice?
Sì. Scegli Testo semplice (.txt) come risultato per ottenere solo le parole riconosciute, con una riga --- n --- tra le pagine. Il nostro contratto di 5 pagine ha dato un file di testo da 14 KB di circa 2.591 parole, pronto da incollare in un documento o in uno strumento di traduzione.
Quali file accetta pdf24 ocr pdf?
PDF scansionati e singole immagini che il browser sa aprire, come JPG, PNG e WebP. Un PDF viene letto pagina per pagina a circa 300 dpi; un'immagine diventa una pagina. Per più foto, uniscile prima con Scansiona in PDF, poi esegui l'OCR su quel PDF.
Quanto è accurato pdf24 ocr pdf?
Su una scansione pulita e dritta di testo stampato è molto accurato: tutte le 2.565 parole alfabetiche del nostro contratto di 5 pagine corrispondevano alla fonte. L'accuratezza cala con sfocatura, caratteri piccoli, pagine storte, timbri e impostazione di lingua sbagliata, e le immagini senza testo possono produrre parole spazzatura.
pdf24 ocr pdf può riconoscere l'arabo?
Sì. Scegli l'arabo come lingua; il livello di testo viene scritto con un carattere arabo incorporato. Il riconoscimento dell'arabo è più sensibile alla qualità della scansione rispetto al testo latino, quindi una scansione nitida a 300 dpi conta ancora di più. Le pagine miste arabo e inglese possono perdere parte della seconda scrittura.
Perché pdf24 ocr pdf non ha trovato testo?
Di solito la lingua è sbagliata, la pagina è capovolta o di lato, oppure la scansione è troppo sfocata. Ruota prima le pagine, scegli la lingua giusta e riprova. Se il PDF ha già un livello di testo l'OCR non serve: Copia da PDF lo legge direttamente.
Posso usare pdf24 ocr pdf su un telefono?
Sì, in Chrome, Safari, Edge e Firefox aggiornati. L'OCR è impegnativo, quindi un telefono impiega più di un computer e richiede che lo schermo resti acceso. Comincia con poche pagine; per le scansioni lunghe, un computer è la scelta più comoda.
Chi realizza lo strumento pdf24 ocr pdf?
Lo realizza il team di pdf24tools. pdf24tools è un sito indipendente, non affiliato a PDF24 né a Geek Software GmbH. La nostra pagina OCR usa il motore open source Tesseract dentro il tuo browser; questa pagina lo descrive solo con i nostri test sui nostri file.
pdf24 OCR PDF: altri strumenti e guide
pdf24 OCR PDF: fonti
- Riconoscimento ottico dei caratteri — Wikipedia
- Tesseract (software) — Wikipedia
- File API — MDN Web Docs