Cómo usar pdf24 OCR PDF en 4 pasos
- Abre el escaneo. Elige un PDF escaneado o la foto de una página (JPG, PNG, WebP), o suéltalo en el recuadro.
- Comprueba el idioma. Elige el idioma del texto entre 11 opciones; la lista empieza en el idioma de esta página.
- Elige el resultado. PDF con texto buscable conserva las páginas y añade texto oculto; Texto plano guarda solo las palabras en un archivo .txt.
- Ejecuta y descarga. Pulsa el botón, espera mientras se reconoce cada página y guarda el archivo -ocr.pdf o .txt.
¿Qué cambia pdf24 OCR PDF en un archivo escaneado?
pdf24 OCR PDF deja intactas todas las páginas originales y añade una capa invisible de palabras reconocidas, colocada sobre las letras correspondientes. Los visores te dejan entonces buscar, seleccionar y copiar el texto, mientras la página sigue mostrando el escaneo original. Las palabras reconocidas con muy poca confianza se omiten en lugar de adivinarse.
“El reconocimiento óptico de caracteres (ROC), generalmente conocido como reconocimiento de caracteres y expresado con frecuencia con la sigla OCR (del inglés Optical Character Recognition), es un proceso dirigido a la digitalización de textos, los cuales identifican automáticamente a partir de una imagen símbolos o caracteres que pertenecen a un determinado alfabeto, para luego almacenarlos en forma de datos.”
| Archivo | Resultado | Palabras | Antes → después | Tiempo |
|---|---|---|---|---|
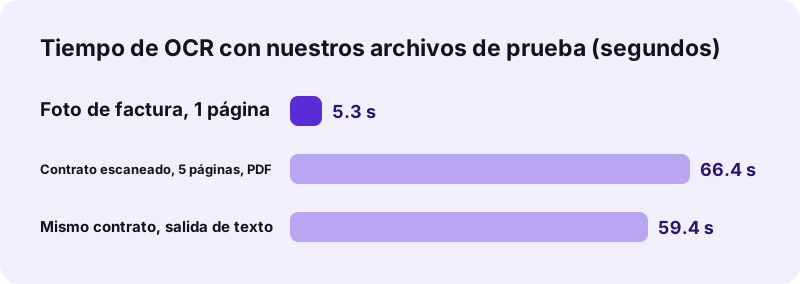
| Foto de factura (PNG, 1 página) | PDF con texto buscable | 54 | 72 KB → 105 KB | 5,3 s |
| Contrato escaneado (PDF, 5 páginas) | PDF con texto buscable | 2575 | 2,46 MB → 2,60 MB | 66,4 s |
| Mismo contrato | Texto plano | unas 2591 | → .txt de 14 KB | 59,4 s |
Precisión de pdf24 OCR PDF con un escaneo limpio
Comprobamos palabra por palabra la salida de texto de pdf24 OCR PDF del contrato de 5 páginas frente a las palabras del documento original: las 2565 palabras alfabéticas eran palabras reales del original, sin ninguna mal leída. Antes del OCR, una búsqueda de thirty (treinta; el contrato estaba en inglés) daba 0 resultados en el escaneo; después del OCR la misma búsqueda encontró 150. La foto de la factura devolvió su texto exacto, incluidos importes como 319.70.
pdf24 OCR PDF en el móvil
pdf24 OCR PDF también funciona en móviles, pero es un trabajo pesado: cada página se renderiza a unos 300 ppp y el motor de reconocimiento la analiza en el propio dispositivo. Cuenta con que un móvil tarde más que los 13 segundos por página de nuestro portátil, mantén la pantalla encendida y empieza con pocas páginas.
pdf24 OCR PDF en el ordenador
En un ordenador, los escaneos largos son prácticos: nuestro contrato de 5 páginas tardó algo más de un minuto. La línea de progreso muestra qué página se está leyendo. La primera ejecución de cada sesión descarga además una vez los datos del idioma, por eso nuestra foto de 1 página tardó 5,3 segundos.
pdf24 OCR PDF: consejo para mejores resultados
Escanea a 300 ppp, mantén las páginas rectas y, con fotos del móvil, usa el filtro Documento o Blanco y negro de escanear a PDF. Para el reconocimiento importan más un buen contraste y unas líneas rectas que el color.
¿Qué idiomas reconoce pdf24 OCR PDF?
pdf24 OCR PDF reconoce 11 idiomas: inglés, francés, español, portugués, alemán, italiano, ruso, árabe, indonesio, turco y vietnamita. Elige el idioma en que está escrito el documento; la lista empieza en el idioma de la página en la que estás. Un idioma mal elegido cuesta sobre todo tildes y letras especiales.
| Idioma | Alfabeto | Nota |
|---|---|---|
| Inglés, francés, español, portugués, alemán, italiano, indonesio, turco, vietnamita | Latino con diacríticos | Elige el idioma exacto para sus diacríticos (é, ñ, ß, ş, ơ) |
| Ruso | Cirílico | Las palabras en alfabeto latino del texto se leen con menos fiabilidad |
| Árabe | Árabe, de derecha a izquierda | Se incrusta una fuente árabe para la capa de texto |
pdf24 OCR PDF con documentos en varios idiomas
Cada ejecución usa un solo idioma. Para una carta en español con nombres en inglés, elige español: los nombres en letras latinas se reconocen igualmente. Para documentos con dos alfabetos, como árabe e inglés, ejecuta el idioma predominante; el otro alfabeto puede salir incompleto.
¿Es privado pdf24 OCR PDF si descarga un motor?
pdf24 OCR PDF descarga el motor de reconocimiento y los datos del idioma desde una biblioteca pública de código la primera vez que lo usas, pero tu archivo nunca viaja en sentido contrario: las páginas se leen, se renderizan y se reconocen en tu dispositivo. Nuestras líneas de resultado indicaron 0 bytes subidos en cada prueba de OCR.
El motor es Tesseract, compilado para ejecutarse dentro del navegador. Descargar código y diccionarios es como cargar una fuente; en esas peticiones no va nada de tu documento, tampoco con nuestro contrato de 2,46 MB. La File API en MDN explica cómo una página lee un archivo local sin enviarlo.
“Tesseract es un motor de reconocimiento óptico de caracteres para varios sistemas operativos. Es software libre, liberado bajo la licencia Apache, Versión 2.0”
¿Por qué pdf24 OCR PDF encuentra palabras erróneas o ninguna?
pdf24 OCR PDF depende de lo que muestra la página. Las fotos borrosas, la letra diminuta, la escritura a mano, los sellos grandes y un idioma mal elegido reducen la precisión. Las imágenes sin texto pueden incluso producir palabras basura: nuestra página de prueba con formas de colores al azar devolvió 457 palabras sin sentido.
Los escaneos limpios y rectos de texto impreso dan los mejores resultados. La tabla resume los problemas más habituales y cómo resolverlos.
| Problema | Solución |
|---|---|
| No se ha reconocido texto | Comprueba el idioma y que la página no esté al revés; gírala con rotar PDF |
| Muchas letras erróneas | Vuelve a escanear a 300 ppp o limpia la foto con escanear a PDF |
| No lee la escritura a mano | El motor está entrenado con texto impreso; la escritura a mano no está soportada |
| Palabras basura en fotos o gráficos | Bórralas en la salida de texto, o aplica OCR solo a las páginas con texto |
| El archivo ya tiene texto | No hace falta OCR: usa copiar texto de PDF o buscar en PDF |
pdf24 OCR PDF y qué hacer después
Un PDF buscable creado con pdf24 OCR PDF abre la puerta a las demás herramientas de texto. Pasos habituales después del OCR:
- Encuentra cada mención de un nombre o un importe con buscar en PDF.
- Copia todo el texto con copiar texto de PDF.
- Convierte el escaneo en un documento editable con PDF a Word, o sigue la guía OCR de PDF a Word.
- Compara dos versiones escaneadas con comparar PDF, tras aplicar OCR a las dos.
- Reduce el resultado con comprimir PDF si tiene que caber en un correo.
pdf24 OCR PDF: preguntas frecuentes
¿Es gratis pdf24 OCR PDF?
Sí. El OCR de pdf24tools es gratuito, sin cuenta, sin marca de agua y sin límite de páginas. El reconocimiento se ejecuta en tu navegador, en tu propio dispositivo, así que no hay tiempo de servidor que cobrar. Los documentos largos simplemente tardan más, unos 13 segundos por página en nuestro portátil.
¿Sube mi escaneo pdf24 OCR PDF?
No. La página descarga una vez el motor de reconocimiento y los datos del idioma, pero tu archivo nunca se envía: nuestras líneas de resultado indicaron 0 bytes subidos en cada prueba. Las páginas se renderizan y se reconocen en tu dispositivo, y no se guarda nada cuando cierras la pestaña.
¿Cuánto tarda pdf24 OCR PDF?
En nuestro portátil con Windows, unos 13 segundos por página: 66,4 segundos para un contrato escaneado de 5 páginas y 5,3 segundos para la foto de una factura de 1 página, incluida la descarga única del idioma. Los móviles son más lentos. La línea de progreso muestra qué página se está reconociendo.
¿Puede pdf24 OCR PDF leer escritura a mano?
No de forma fiable. El motor está entrenado con texto impreso, así que las notas manuscritas suelen salir como letras erróneas o se omiten. Los formularios impresos con respuestas a mano funcionan para la parte impresa; escribe tú mismo las respuestas manuscritas si tienen que poder buscarse.
¿Cambia pdf24 OCR PDF el aspecto de mi escaneo?
No. Las páginas originales quedan exactamente como estaban; las palabras reconocidas se añaden como texto invisible sobre las letras correspondientes. Solo crece un poco el tamaño del archivo, de 2,46 MB a 2,60 MB en nuestro contrato de 5 páginas, sobre todo por la fuente incrustada.
¿Puede pdf24 OCR PDF guardar texto plano?
Sí. Elige Texto plano (.txt) como resultado para obtener solo las palabras reconocidas, con una línea --- n --- entre páginas. Nuestro contrato de 5 páginas dio un archivo de texto de 14 KB con unas 2591 palabras, listo para pegarlo en un documento o en una herramienta de traducción.
¿Qué archivos acepta pdf24 OCR PDF?
PDF escaneados e imágenes sueltas que tu navegador pueda abrir, como JPG, PNG y WebP. Un PDF se lee página a página a unos 300 ppp; una imagen se convierte en una página. Si tienes varias fotos, combínalas primero con escanear a PDF y después aplica OCR a ese PDF.
¿Qué precisión tiene pdf24 OCR PDF?
Con un escaneo limpio y recto de texto impreso es muy preciso: las 2565 palabras alfabéticas de nuestro contrato de 5 páginas coincidían con el original. La precisión baja con el desenfoque, la letra pequeña, las páginas torcidas, los sellos y un idioma mal elegido, y las imágenes sin texto pueden producir palabras basura.
¿Puede pdf24 OCR PDF reconocer árabe?
Sí. Elige árabe como idioma; la capa de texto se escribe con una fuente árabe incrustada. El reconocimiento del árabe es más sensible a la calidad del escaneo que el del texto latino, así que un escaneo nítido a 300 ppp importa todavía más. Las páginas mixtas en árabe e inglés pueden perder parte del segundo alfabeto.
¿Por qué pdf24 OCR PDF no encontró texto?
Normalmente el idioma no es el correcto, la página está al revés o de lado, o el escaneo está demasiado borroso. Gira primero las páginas, elige el idioma adecuado y vuelve a intentarlo. Si el PDF ya tiene una capa de texto, no hace falta OCR: copiar texto de PDF la lee directamente.
¿Puedo usar pdf24 OCR PDF en el móvil?
Sí, en las versiones actuales de Chrome, Safari, Edge y Firefox. El OCR es exigente, así que un móvil tarda más que un ordenador y necesita la pantalla encendida. Empieza con pocas páginas; para escaneos largos, un ordenador es la opción más cómoda.
¿Quién hace la herramienta pdf24 OCR PDF?
La hace el equipo de pdf24tools. pdf24tools es un sitio web independiente y no tiene relación con PDF24 ni con Geek Software GmbH. Nuestra página de OCR usa el motor de código abierto Tesseract dentro de tu navegador; esta página lo describe solo a partir de nuestras propias pruebas con nuestros propios archivos.
Más herramientas y tutoriales de pdf24 OCR PDF
pdf24 OCR PDF: fuentes
- Reconocimiento óptico de caracteres — Wikipedia
- Tesseract (software) — Wikipedia
- File API — MDN Web Docs