Как пользоваться pdf24 ocr pdf за 4 шага
- Откройте скан. Выберите сканированный PDF или фото страницы (JPG, PNG, WebP) либо перетащите файл в поле.
- Проверьте язык. Выберите язык текста из 11 вариантов; по умолчанию стоит язык этой страницы.
- Выберите результат. «PDF с поиском» сохраняет страницы и добавляет скрытый текст; «Простой текст» сохраняет только слова в файл .txt.
- Запустите и скачайте. Нажмите кнопку, дождитесь распознавания каждой страницы, затем сохраните файл -ocr.pdf или .txt.
Что pdf24 ocr pdf меняет в сканированном файле?
OCR оставляет каждую исходную страницу нетронутой и добавляет невидимый слой распознанных слов, расставленных над соответствующими буквами. Программы для чтения тогда позволяют искать, выделять и копировать текст, а страница по-прежнему показывает исходный скан. Слова с очень низкой уверенностью распознавания пропускаются, а не угадываются.
“Optical character recognition (OCR) or optical character reader is the electronic or mechanical conversion of images of typed, handwritten or printed text into machine-encoded text (Оптическое распознавание символов (OCR) — электронное или механическое преобразование изображений печатного или рукописного текста в машиночитаемый текст).”
| Файл | Результат | Слов | До → после | Время |
|---|---|---|---|---|
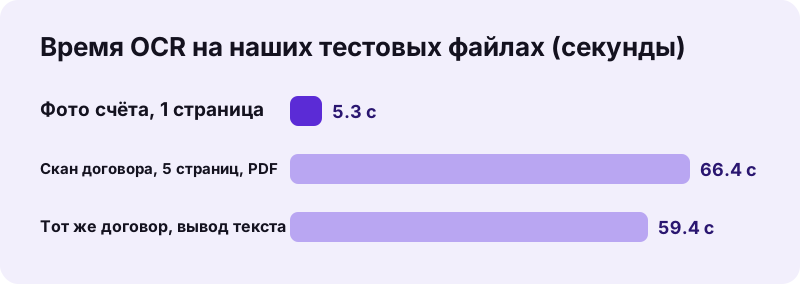
| Фото счёта (PNG, 1 страница) | PDF с поиском | 54 | 72 КБ → 105 КБ | 5,3 с |
| Скан договора (PDF, 5 страниц) | PDF с поиском | 2 575 | 2,46 МБ → 2,60 МБ | 66,4 с |
| Тот же договор | Простой текст | около 2 591 | → 14 КБ .txt | 59,4 с |
Если вам нужен только текст, а не PDF, pdf24 ocr pdf сохранит его прямо в .txt, и вы сразу сможете вставить слова в письмо, таблицу или сервис перевода.
Точность pdf24 ocr pdf на чистом скане
Мы сверили текстовый вывод pdf24 ocr pdf для договора на 5 страниц слово за словом со словами исходного документа: все 2 565 буквенных слов оказались настоящими словами источника, ошибочно прочитанных не было. До распознавания поиск слова thirty находил в скане 0 совпадений, после — 150. Фото счёта вернулось точным текстом, включая суммы вроде 319,70. Таким образом pdf24 ocr pdf подходит для проверки договоров, счетов и справок, где важны именно цифры.
pdf24 ocr pdf на телефоне
pdf24 ocr pdf работает и на телефонах, но это тяжёлая работа: каждая страница рисуется примерно в 300 dpi и анализируется механизмом распознавания прямо на устройстве. Телефону понадобится больше времени, чем 13 секунд на страницу на нашем ноутбуке; держите экран включённым и начните с нескольких страниц.
pdf24 ocr pdf на компьютере
На компьютере длинные сканы вполне осуществимы: наш договор из 5 страниц занял чуть больше минуты. Строка хода показывает, какая страница читается. При первом запуске за сеанс ещё один раз скачиваются языковые данные, поэтому наше фото на 1 страницу заняло 5,3 секунды.
pdf24 ocr pdf: совет для лучшего результата
Сканируйте в 300 dpi, держите страницы ровно и для фото с телефона применяйте очистку «Документ» или «Чёрно-белое» в «Сканировать в PDF». Чистый контраст и ровные строки для распознавания важнее цвета.
Какие языки распознаёт pdf24 ocr pdf?
OCR распознаёт 11 языков: английский, французский, испанский, португальский, немецкий, итальянский, русский, арабский, индонезийский, турецкий и вьетнамский. Выберите язык, на котором написан документ; список начинается с языка страницы, на которой вы находитесь. Неверный язык в основном стоит вам диакритических знаков и специальных букв.
| Язык | Письменность | Примечание |
|---|---|---|
| Английский, французский, испанский, португальский, немецкий, итальянский, индонезийский, турецкий, вьетнамский | Латиница с диакритикой | Выбирайте точный язык ради знаков (é, ß, ş, ơ) |
| Русский | Кириллица | Латинские слова в тексте читаются менее надёжно |
| Арабский | Арабская, справа налево | Для текстового слоя встраивается арабский шрифт |
pdf24 ocr pdf с документами на смешанных языках
За один запуск используется один язык. Для французского письма с английскими именами выберите французский: имена латиницей всё равно распознаются. Для документов с двумя письменностями, например арабской и английской, запускайте преобладающий язык; вторая письменность может получиться неполной.
Приватен ли pdf24 ocr pdf, если он скачивает механизм?
OCR при первом использовании скачивает механизм распознавания и языковые данные из публичной библиотеки кода, но ваш файл не движется в обратную сторону: страницы читаются, рисуются и распознаются на вашем устройстве. Наши строки результата для каждого запуска OCR показали 0 загруженных байт, включая договор на 2,46 МБ.
Механизм называется Tesseract и скомпилирован для работы прямо в браузере. Загрузка кода и словарей похожа на загрузку шрифта: в этих запросах нет ничего о вашем документе. Статья File API на MDN объясняет, как страница читает локальный файл, не отправляя его. Поэтому pdf24 ocr pdf можно спокойно использовать для паспортов, справок и медицинских бумаг.
“Tesseract is an optical character recognition engine for various operating systems. It is free software, released under the Apache License. (Tesseract — механизм оптического распознавания символов для разных операционных систем. Это свободное программное обеспечение, выпущенное под лицензией Apache.)”
Почему pdf24 ocr pdf находит неверные слова или не находит ничего?
Результат OCR зависит от того, что показывает страница. Размытые фото, мелкий шрифт, рукописный текст, плотные штампы и неверный язык снижают точность. Картинки без текста могут даже дать мусорные слова: наша страница из случайных цветных фигур вернула 457 бессмысленных слов. Чистые ровные сканы печатного текста дают лучшие результаты.
| Проблема | Решение |
|---|---|
| Текст не распознан | Проверьте язык и убедитесь, что страница не перевёрнута; поверните её через «Повернуть страницы PDF» |
| Много неверных букв | Отсканируйте заново в 300 dpi или очистите фото через «Сканировать в PDF» |
| Рукописный текст не читается | Механизм обучен печатному тексту; рукописный не поддерживается |
| Мусорные слова на фото и диаграммах | Удалите их в текстовом результате или распознавайте только страницы с текстом |
| В файле уже есть текст | OCR не нужен: используйте «Копировать из PDF» или «Поиск по PDF» |
Как подготовить скан для pdf24 ocr pdf
Качество распознавания в OCR в первую очередь определяется самим сканом. Ровная страница, разрешение 300 dpi, равномерный свет без теней и контрастный чёрный текст на светлом фоне дают почти безошибочный результат, тогда как перекос, блики и сжатие JPEG с низким качеством быстро увеличивают число ошибок.
- Положите страницу ровно и снимайте строго сверху, без наклона телефона.
- Используйте дневной свет или два источника света по бокам, чтобы не было тени от руки.
- Включите режим «Документ» или «Чёрно-белое» в сканировании, чтобы убрать цветной фон.
- Снимайте по одной странице и проверяйте резкость, увеличив снимок.
Перед запуском pdf24 ocr pdf стоит взглянуть на страницу в крупном масштабе: если вам самим трудно прочитать мелкий шрифт, механизму распознавания будет не легче. В таком случае лучше пересканировать страницу, чем править ошибки в готовом тексте. Для длинных документов распознавайте сначала две-три страницы, оцените результат и только потом запускайте весь файл, чтобы не тратить минуты впустую.
pdf24 ocr pdf и что делать дальше
PDF с поиском, полученный через pdf24 ocr pdf, открывает дорогу к остальным текстовым инструментам. Типичные следующие шаги после OCR:
- Найдите все упоминания имени или суммы через «Поиск по PDF».
- Скопируйте весь текст через «Копировать из PDF».
- Превратите скан в редактируемый документ через «PDF в Word».
- Сравните две отсканированные версии через «Сравнить PDF», выполнив OCR для обеих.
- Уменьшите результат через «Сжатие PDF», если он должен пройти по почте.
pdf24 OCR PDF: частые вопросы
pdf24 ocr pdf бесплатный?
Да. Распознавание на pdf24tools бесплатно, без аккаунта, водяного знака и ограничения числа страниц. Оно выполняется в вашем браузере на вашем устройстве, поэтому серверного времени, за которое можно было бы брать плату, нет. Длинные документы просто занимают больше времени: на нашем ноутбуке около 13 секунд на страницу.
Загружает ли pdf24 ocr pdf мой скан?
Нет. Страница один раз скачивает механизм распознавания и языковые данные, но ваш файл никуда не отправляется: наши строки результата при каждом запуске показывали 0 загруженных байт. Страницы рисуются и распознаются на вашем устройстве, а после закрытия вкладки ничего не хранится. Поэтому личные сканы остаются только у вас.
Сколько времени занимает pdf24 ocr pdf?
На нашем ноутбуке с Windows около 13 секунд на страницу: 66,4 секунды для скана договора на 5 страниц и 5,3 секунды для фото счёта на 1 страницу, включая однократную загрузку языка. Телефоны медленнее. Строка хода показывает, какая страница распознаётся прямо сейчас.
Умеет ли pdf24 ocr pdf читать рукописный текст?
Ненадёжно. Механизм обучен печатному тексту, поэтому рукописные заметки обычно выходят неверными буквами или пропускаются. Печатные формы с рукописными ответами обрабатываются в печатной части; если рукописные ответы должны искаться, наберите их сами. Печатные слова на бланке при этом распознаются без проблем. Рукописный текст механизм обычно пропускает.
Меняет ли pdf24 ocr pdf вид моего скана?
Нет. Исходные страницы остаются точно такими, какими были; распознанные слова добавляются невидимым текстом над соответствующими буквами. Немного растёт лишь размер файла: с 2,46 МБ до 2,60 МБ для нашего договора на 5 страниц, в основном из-за встроенного шрифта. Видимой разницы вы не заметите, пока не попробуете выделить текст. Вид страницы не меняется.
Может ли pdf24 ocr pdf сохранить простой текст?
Да. Выберите «Простой текст (.txt)», чтобы получить только распознанные слова со строкой --- n --- между страницами. Наш договор на 5 страниц дал текстовый файл на 14 КБ примерно с 2 591 словом, готовый для вставки в документ или сервис перевода. Простой текст удобен, если вам нужны только слова, без страниц.
Какие файлы принимает pdf24 ocr pdf?
Сканированные PDF и отдельные изображения, которые открывает браузер, например JPG, PNG и WebP. PDF читается постранично примерно в 300 dpi; изображение становится одной страницей. Для нескольких фото сначала объедините их через «Сканировать в PDF», а затем запустите распознавание на этом PDF. Максимальный размер ограничен лишь памятью вашего устройства.
Насколько точен pdf24 ocr pdf?
На чистом ровном скане печатного текста очень точен: все 2 565 буквенных слов нашего договора на 5 страниц совпали с источником. Точность падает при размытии, мелком шрифте, перекосе страниц, штампах и неверном языке, а картинки без текста могут дать мусорные слова. Поэтому для важных документов стоит сверить цифры с оригиналом.
Распознаёт ли pdf24 ocr pdf арабский?
Да. Выберите арабский язык; текстовый слой записывается со встроенным арабским шрифтом. Распознавание арабского чувствительнее к качеству скана, чем латиница, поэтому чёткий скан в 300 dpi важен ещё больше. На страницах со смесью арабского и английского вторая письменность может потеряться частично. Если смесь языков неизбежна, выбирайте тот, на котором написано больше слов.
Почему pdf24 ocr pdf не нашёл текст?
Обычно неверен язык, страница перевёрнута или повёрнута набок либо скан слишком размыт. Сначала поверните страницы, выберите правильный язык и повторите попытку. Если в PDF уже есть текстовый слой, OCR не нужен: «Копировать из PDF» читает его напрямую. Проверьте также, что страница не зеркальна и не повёрнута на 90 градусов.
Можно ли пользоваться pdf24 ocr pdf на телефоне?
Да, в современных Chrome, Safari, Edge и Firefox. Распознавание требует много ресурсов, поэтому телефону нужно больше времени, чем компьютеру, и экран должен оставаться включённым. Начните с нескольких страниц; для длинных сканов удобнее компьютер. Для долгих сканов удобнее подключить зарядку. Заряд расходуется заметно быстрее обычного.
Кто делает инструмент pdf24 ocr pdf?
Его делает команда pdf24tools. pdf24tools — независимый сайт, не связанный с PDF24 или Geek Software GmbH. Наша страница OCR использует открытый механизм Tesseract внутри вашего браузера; эта страница описывает её только по нашим собственным тестам на наших собственных файлах. Вопросы и замечания присылайте на contact@pdf24tools.org.
pdf24 OCR PDF: другие инструменты и руководства
pdf24 OCR PDF: источники
- Оптическое распознавание символов — Википедия
- Tesseract (software) — Википедия
- File API — MDN Web Docs