Почему pdf24 ocr not working на моём скане?
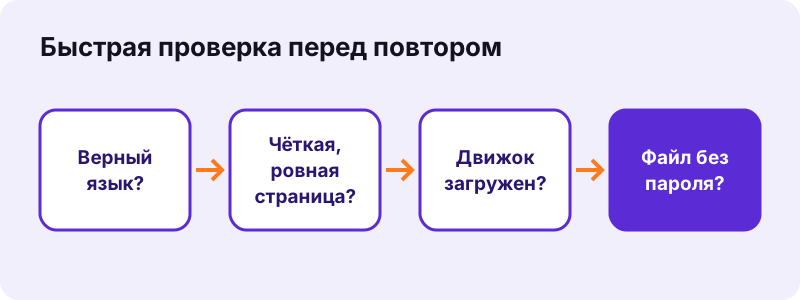
Когда OCR не работает на скане, обычно движок не видит чётких букв: страница слишком мелкая или размытая, повёрнута, на другом языке, чем выбранный, или написана от руки. Реже сам движок так и не загрузился, потому что сетевой фильтр заблокировал скачивание, или файл защищён паролем.
| Признак | Самая вероятная причина | Решение |
|---|---|---|
| Текст не распознан | Мало пикселей, повёрнутая страница или неверный язык | Пересканировать в 300 dpi, повернуть, выбрать язык |
| Текст полон ошибок | Низкое разрешение или диакритика другого языка | Выше разрешение, подходящий язык |
| Зависло на «Загрузка движка OCR» | Загрузка движка заблокирована или нет сети | Разрешить cdn.jsdelivr.net, переподключиться |
| Сообщение о пароле | Установлен пароль на открытие | Разблокировать PDF паролем |
| Случайные буквы на фото | На картинке нет текста | Использовать OCR только для документов |
Идите по таблице сверху вниз. На наших тестовых сканах первые две строки объясняют большинство случаев pdf24 ocr not working, и обе проблемы решаются меньше чем за минуту: переключите язык или замените крошечное либо размытое изображение более чётким. Остальные строки встречаются реже, но тоже проверяются за пару кликов.
pdf24 ocr not working: сначала проверьте язык
Страница OCR заранее выбирает язык по умолчанию, и он не обязательно совпадает с языком вашего документа. Французский, немецкий или турецкий документ, распознанный как английский, теряет диакритику и многие слова. Перед нажатием кнопки выберите язык документа из 11 в списке. Для документа на двух языках выберите тот, на котором написана большая часть текста.
pdf24 ocr not working на повёрнутых страницах
Страницы, отсканированные боком или вверх ногами, дают мало текста или не дают его совсем. Поверните их ровно через Повернуть страницы PDF, скачайте повёрнутую копию и запустите OCR для этого файла. Проверьте каждую страницу, потому что одну повёрнутую страницу в длинном скане легко пропустить.
pdf24 ocr not working с рукописным текстом
Движок обучен на печатном тексте. Аккуратные печатные заглавные буквы иногда распознаются; слитный рукописный почерк обычно даёт неверные слова или ничего. Это ограничение модели распознавания, а не настройка, которую можно изменить, поэтому короткие рукописные заметки проще перепечатать вручную.
pdf24 ocr not working: совет для фото с телефона
Держите телефон ровно над страницей, заполните кадр листом бумаги и снимайте при дневном свете. Тени поперёк текста и наклон сбивают движок сильнее, чем немного меньшее разрешение. Наш инструмент Скан в PDF может сначала очистить фото фильтром «Документ», который выравнивает фон и повышает контраст.
Объясняет ли разрешение pdf24 ocr not working?
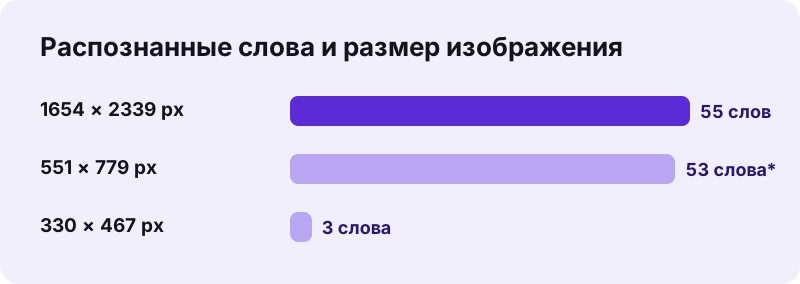
Разрешение — самая частая причина плохой работы OCR. Наш скан счёта размером 1654 × 2339 пикселей дал около 55 верных слов. Уменьшенный до трети, он всё ещё дал 53 слова, но с ошибками вроде 2550 вместо 25.50. При пятой части размера вернулось всего 3 слова, и все бесполезные.
| Размер изображения | Файл | Слов | Время | Качество |
|---|---|---|---|---|
| 1654 × 2339 px | 72 КБ | около 55 | 4,0 с | Верно |
| 551 × 779 px | 33 КБ | около 53 | 2,8 с | Allas Trading, 2550, 309 |
| 330 × 467 px | 15 КБ | около 3 | 1,8 с | Непригодно |
“Image resolution is the level of detail of an image. (Разрешение изображения — это уровень детализации изображения.)”
Перед распознаванием страницы PDF отрисовываются примерно в 300 dpi, но это не может вернуть детали, которых в плохом скане никогда не было. Пересканируйте страницу в 300 dpi или сфотографируйте её ближе. Для мелкого шрифта, например в сносках или на чеках, разница между 150 и 300 dpi решает, будет ли текст прочитан вообще.
Что делать, если pdf24 ocr not working и всё зависло на загрузке?
Когда OCR завис на «Загрузка движка OCR и языковых данных», браузер не смог скачать файлы движка. Движок и языковые пакеты при первом использовании приходят с cdn.jsdelivr.net. Школьные и офисные файрволы, строгие блокировщики рекламы или оборванное соединение останавливают эту загрузку; ваш документ в ней никогда не участвует.
- Смотрите на проценты: если минуту держится 0 %, загрузка заблокирована.
- Разрешите
cdn.jsdelivr.netв блокировщике или попробуйте другую сеть. - После переподключения перезагрузите страницу; наполовину загруженный движок не продолжает загрузку.
- Первый запуск на устройстве самый медленный; следующие используют кэшированные файлы.
В наших тестах первый запуск OCR вместе со скачиванием движка занял 75,1 секунды для 5 страниц и 82,2 секунды для 4 тяжёлых страниц. Если у вас нет никакого прогресса, то pdf24 ocr not working — это проблема сети, а не файла. Повторные запуски на том же устройстве начинаются заметно быстрее, потому что движок и языковые данные уже лежат в кэше браузера и не скачиваются заново.
Почему при pdf24 ocr not working появляется бессмысленный текст?
Бессмысленный текст появляется, когда движок OCR пытается прочитать буквы на картинке, где их нет, например на фотографии, логотипе или узоре. Наше тестовое фото вообще без текста всё равно вернуло около 494 слов шума за 48,1 секунды. Поэтому одно лишь число слов не доказывает, что распознавание сработало.
Всегда открывайте результат и сверяйте несколько строк с оригиналом. В PDF с поиском выделите предложение и вставьте его в текстовый редактор; в выводе .txt сравните имена и числа. Если в смешанном документе есть страницы с фотографиями, удалите их через Удалить страницы PDF до запуска OCR.
Быстрый способ оценить жалобу pdf24 ocr not working — попробовать текстовый вывод на одной странице. Если в .txt видны настоящие слова с вашей страницы, распознавание работает, и чистить нужно только исходные страницы; если там случайные буквы, на странице нет текста, который движок может прочитать.
pdf24 ocr not working на защищённых или повреждённых PDF
Защищённый PDF останавливает OCR сообщением о том, что файл защищён паролем. Снимите пароль на открытие через «Разблокировать PDF», используя известный вам пароль, и запустите OCR для разблокированной копии. Повреждённый файл, который не открывает ни одна программа, часто можно сначала пересобрать через «Восстановить PDF»: наш сломанный тестовый файл он исправил за 0,8 секунды.
- Разблокировать PDF: снимает запреты на печать и копирование без пароля; снимает пароль на открытие, когда вы его вводите.
- Восстановить PDF: пересобирает сломанный индекс файла, чтобы страницы снова читались.
- Затем вернитесь в OCR PDF с исправленной копией.
Как только копия открывается без пароля, проблема pdf24 ocr not working для этого файла обычно решена; остаются причины, связанные с изображением, о которых говорилось выше. Исходный защищённый файл при этом не меняется, так что его можно хранить отдельно.
Бывает ли pdf24 ocr not working из-за слишком большого файла?
Большие сканы делают OCR медленным, а не сломанным, потому что каждая страница перерисовывается примерно в 300 dpi и распознаётся на вашем собственном устройстве. Нашему скану на 4 страницы и 8,07 МБ понадобилось 82,2 секунды. Скан на 100 страниц на телефоне может занять много минут и остановиться, если браузеру не хватит памяти или вкладка уснёт.
Делите длинные сканы на части по 10–20 страниц через Разделить PDF, распознавайте каждую часть и соединяйте результаты через Объединить PDF. Пока идёт работа, держите экран включённым, а вкладку на переднем плане. Если pdf24 ocr not working оказывается ограничением памяти, ноутбук обработает тот же файл намного быстрее телефона.
Ни одно из этих решений не влияет на приватность: файл читается через File API и обрабатывается локально, а наши журналы запросов показали 0 байт загрузки. Даже при сбое распознавания ваш документ не уходит ни на какой сервер.
pdf24 OCR not working: частые вопросы
Почему при pdf24 ocr not working пишет, что текст не распознан?
Движок не нашёл букв, которые может прочитать. Проверьте, что язык совпадает с языком документа, что страница стоит ровно и что скан чёткий. В нашем тесте страница, уменьшенная до 330 × 467 пикселей, дала всего 3 слова, а скан в полном размере — около 55 верных слов.
Связан ли pdf24 ocr not working с моим браузером?
Редко. Для OCR нужен современный браузер с WebAssembly и веб-воркерами, а их поддерживают Chrome, Edge, Firefox и Safari. Очень старые версии или расширения, блокирующие воркеры либо скрипты с cdn.jsdelivr.net, не дают движку запуститься. Обновите браузер или попробуйте приватное окно без расширений.
Может ли pdf24 ocr not working быть вызван файрволом?
Да. Движок и языковые данные скачиваются с cdn.jsdelivr.net при первом запуске. Фильтры в компаниях, школах или публичном Wi-Fi иногда блокируют этот адрес, и прогресс остаётся на 0 %. Попробуйте другую сеть или попросите администратора разрешить адрес; ваш документ при этом никуда не отправляется.
Почему pdf24 ocr not working на рукописном тексте?
Модель распознавания обучена на печатных буквах, поэтому слитный почерк обычно даёт неверные слова или ничего. Аккуратные печатные заглавные буквы иногда срабатывают. Настройки, которая улучшила бы распознавание почерка, нет, поэтому короткие рукописные заметки быстрее перепечатать, чем исправлять результат распознавания. Печатные бланки с рукописными полями распознаются частично: печатная часть читается нормально.
Означает ли pdf24 ocr not working, что файл загрузился и не обработался?
Нет. Ничего не загружается ни на каком этапе: браузер открывает ваш файл локально и выполняет распознавание прямо на странице. Наши журналы запросов не показали ни одного POST-запроса. Скачиваются только движок и языковые данные, и в них нет ничего из вашего документа.
Почему при pdf24 ocr not working неверная диакритика?
Диакритика ломается, когда выбранный язык отличается от языка документа. Английская модель не ожидает букв вроде é, ü или ç, поэтому заменяет или пропускает их. Выберите французский, немецкий, испанский, португальский, итальянский, турецкий или вьетнамский язык под текст и запустите распознавание снова. Результат с правильным языком обычно заметно чище.
Сколько должен длиться OCR, чтобы считать, что pdf24 ocr not working?
Рассчитывайте примерно на 15–20 секунд на отсканированную страницу на ноутбуке плюс первое скачивание движка. Наш скан на 5 страниц занял 75,1 секунды, а тяжёлый скан на 4 страницы — 82,2 секунды. Если счётчик страниц не двигается несколько минут, перезагрузите страницу и попробуйте файл покороче.
Можно ли исправить pdf24 ocr not working поворотом страниц?
Часто да. Страницы боком и вверх ногами дают мало текста или ничего. Поверните их ровно через «Повернуть страницы PDF», сохраните новую копию и запустите OCR для неё. Смешанные сканы, где повёрнута только одна страница, встречаются часто, поэтому сначала проверьте каждую страницу в предпросмотре.
Почему pdf24 ocr not working на фото вывески?
OCR создан для документов: тёмный текст на светлом ровном фоне. На фото вывесок, экранов или упаковок есть перспектива, блики и декоративные шрифты, которые дают плохой результат. Фото вообще без текста в нашем тесте даже выдало около 494 слов шума, поэтому для таких снимков OCR не подходит.
Бывает ли pdf24 ocr not working на арабском тексте?
Арабский входит в число 11 языков, поэтому он распознаётся, когда выбран арабский и печать чёткая. Мелкие, малоконтрастные или декоративные арабские шрифты снижают точность, как и в любом другом языке. Используйте чёткий скан примерно в 300 dpi и сверяйте распознанный текст с оригиналом.
Одинаков ли pdf24 ocr not working на других OCR-сайтах?
За другие сервисы мы говорить не можем. pdf24tools — независимый сайт, не связанный с PDF24 или Geek Software GmbH; этот гайд описывает наш собственный OCR, который запускает открытый движок Tesseract в вашем браузере. Решения здесь основаны на наших измерениях от 2 ноября 2026 года.
Бывает ли pdf24 ocr not working с файлами под паролем?
Да. Файл, которому нужен пароль для открытия, останавливает работу сообщением с просьбой снять защиту. Используйте «Разблокировать PDF» с известным вам паролем, затем запустите OCR для разблокированной копии. Файлы, у которых есть только запреты на печать или копирование, разблокируются без пароля, и OCR после этого работает как обычно.
Что делать, если pdf24 ocr not working остаётся после всех исправлений?
Попробуйте текстовый вывод вместо PDF, чтобы увидеть, что движок на самом деле читает, проверьте одну чистую страницу и используйте ноутбук вместо телефона. Если чистая, ровная страница в 300 dpi на правильном языке всё равно не распознаётся, напишите нам через страницу контактов и опишите файл.
pdf24 OCR not working: другие инструменты и руководства
pdf24 OCR not working: источники
- Оптическое распознавание символов — Wikipedia
- Image resolution — Wikipedia
- Tesseract (software) — Wikipedia
- File API — MDN Web Docs