Por que o pdf24 OCR não funciona na minha digitalização?
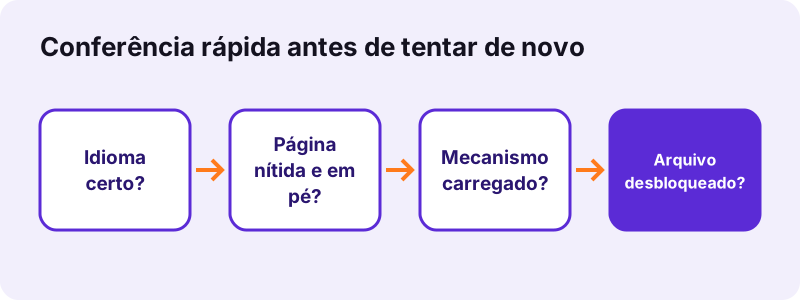
Quando o pdf24 OCR não funciona em uma digitalização, normalmente o mecanismo não consegue ver letras nítidas: a página é pequena ou borrada demais, está girada, está em outro idioma que não o selecionado ou é manuscrita. Com menos frequência, o mecanismo nem terminou de carregar porque um filtro de rede bloqueou o download, ou o arquivo tem senha.
| Sintoma | Causa mais provável | Solução |
|---|---|---|
| Nenhum texto foi reconhecido | Poucos pixels, página girada ou idioma errado | Digitalize de novo a 300 dpi, gire, defina o idioma |
| Texto cheio de erros | Baixa resolução ou acentos de outro idioma | Resolução maior, idioma correspondente |
| Parado em Carregando o mecanismo de OCR | Download do mecanismo bloqueado ou sem conexão | Libere cdn.jsdelivr.net, reconecte |
| Mensagem de senha | Senha de abertura definida | Desbloquear PDF com a senha |
| Letras aleatórias em uma foto | A imagem não contém texto | Use OCR só em documentos |
Percorra a tabela de cima para baixo. Nas nossas digitalizações de teste, as duas primeiras linhas explicam a maioria dos casos em que o OCR falha, e as duas se resolvem em menos de um minuto: troque o idioma ou substitua uma imagem minúscula ou borrada por uma mais nítida.
pdf24 OCR não funciona: confira o idioma primeiro
A página de OCR pré-seleciona o idioma do site que você abriu. Um documento em francês, alemão ou turco reconhecido em outro idioma perde os acentos e muitas palavras, e o mesmo vale para um texto em português lido como inglês, que perde ç, ã e é. Escolha o idioma do documento entre os 11 da lista antes de tocar no botão.
pdf24 OCR não funciona em páginas giradas
Páginas digitalizadas de lado ou de cabeça para baixo dão pouco ou nenhum texto. Coloque-as em pé com Girar PDF, baixe a cópia girada e aplique o OCR nesse arquivo. Confira todas as páginas, porque uma única página girada em uma digitalização longa passa despercebida com facilidade.
pdf24 OCR não funciona com letra manuscrita
O mecanismo é treinado com texto impresso. Letras de forma bem feitas às vezes funcionam; letra cursiva normalmente retorna palavras erradas ou nada. É um limite do modelo de reconhecimento, não uma configuração que você possa mudar, então digite as anotações manuscritas curtas.
pdf24 OCR não funciona: dica para fotos de celular
Segure o celular reto sobre a página, preencha o quadro com o papel e use luz do dia. Sombras sobre o texto e um ângulo inclinado confundem o mecanismo mais do que uma resolução um pouco menor. Nossa ferramenta Digitalizar PDF pode limpar a foto antes com o filtro Documento.
A resolução explica quando o pdf24 OCR não funciona?
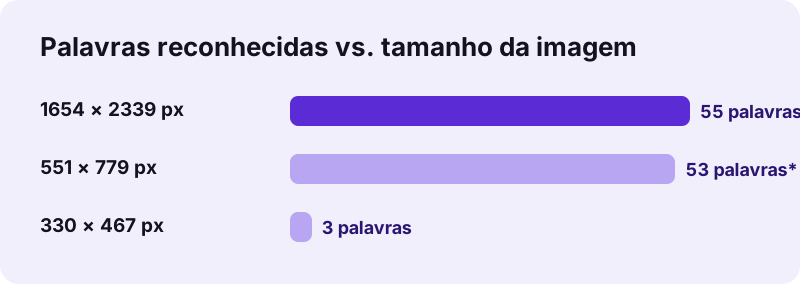
A resolução é o motivo mais comum quando o pdf24 OCR não funciona bem. Nossa digitalização de fatura com 1654 × 2339 pixels deu cerca de 55 palavras corretas. Reduzida a um terço, ainda encontrou 53 palavras, mas com erros como 2550 no lugar de 25.50. Com um quinto do tamanho, só 3 palavras voltaram, todas inúteis.
| Tamanho da imagem | Arquivo | Palavras | Tempo | Qualidade |
|---|---|---|---|---|
| 1654 × 2339 px | 72 KB | cerca de 55 | 4,0 s | Correta |
| 551 × 779 px | 33 KB | cerca de 53 | 2,8 s | Allas Trading, 2550, 309 |
| 330 × 467 px | 15 KB | cerca de 3 | 1,8 s | Inútil |
“Image resolution is the level of detail of an image. (A resolução de imagem é o nível de detalhe de uma imagem.)”
As páginas de PDF são renderizadas a cerca de 300 dpi antes do reconhecimento, mas isso não recupera um detalhe que uma digitalização de baixa qualidade nunca teve. Digitalize de novo a 300 dpi, ou fotografe a página mais de perto.
E se o pdf24 OCR não funciona porque ficou parado carregando?
Quando o pdf24 OCR não funciona e fica parado em Carregando o mecanismo de OCR e os dados do idioma, o navegador não conseguiu baixar os arquivos do mecanismo. O mecanismo e os pacotes de idioma vêm de cdn.jsdelivr.net no primeiro uso. Firewalls de escolas e escritórios, bloqueadores rígidos ou uma conexão que caiu impedem esse download.
- Veja a porcentagem: se ela ficar em 0 % por um minuto, o download está bloqueado.
- Libere
cdn.jsdelivr.netno seu bloqueador, ou tente outra rede. - Recarregue a página depois de reconectar; um mecanismo carregado pela metade não retoma o download.
- A primeira execução em um aparelho é a mais lenta; as seguintes reutilizam os arquivos em cache.
Nos nossos testes, a primeira execução de OCR, com o download do mecanismo, levou 75,1 segundos para 5 páginas e 82,2 segundos para 4 páginas pesadas. Se a sua não mostrar progresso nenhum, o problema é de rede, não do arquivo; o seu documento nunca faz parte desse download.
Por que o pdf24 OCR não funciona e mostra um texto sem sentido?
O texto sem sentido aparece quando o mecanismo de OCR tenta ler letras em uma imagem que não tem nenhuma, como uma foto, um logotipo ou uma estampa. Nossa foto de teste sem nenhum texto ainda retornou cerca de 494 palavras de ruído em 48,1 segundos. Por isso, a contagem de palavras sozinha não prova que o reconhecimento funcionou.
Sempre abra o resultado e compare algumas linhas com o original. No PDF pesquisável, selecione uma frase e cole-a em um editor de texto; na saída .txt, confira nomes e números. Se um documento misto tiver páginas de fotos, remova-as com Remover páginas antes de aplicar o OCR.
Um jeito rápido de avaliar quando o pdf24 OCR não funciona é testar a saída de texto em uma única página. Se o .txt mostrar palavras reais da sua página, o reconhecimento funciona e só as páginas de origem precisam de limpeza; se mostrar letras aleatórias, a página não tem texto legível para o mecanismo.
pdf24 OCR não funciona em PDFs protegidos ou danificados
Um PDF protegido interrompe o OCR com uma mensagem de que o arquivo tem senha. Remova a senha de abertura com Desbloquear PDF, usando a senha que você conhece, e aplique o OCR na cópia desbloqueada. Um arquivo danificado que nenhum leitor abre muitas vezes pode ser reconstruído antes com Reparar PDF, que consertou nosso arquivo de teste em 0,8 segundo.
- Desbloquear PDF: remove limites de impressão e cópia sem senha; remove uma senha de abertura quando você a digita.
- Reparar PDF: reconstrói o índice quebrado de um arquivo para as páginas poderem ser lidas de novo.
- Depois, volte ao OCR PDF com a cópia corrigida.
Quando a cópia abre sem senha, o problema normalmente está resolvido; as causas restantes são as de imagem tratadas acima.
O pdf24 OCR não funciona porque o arquivo é grande demais?
O pdf24 OCR fica lento, mas não quebra, com digitalizações grandes, porque cada página é redesenhada a cerca de 300 dpi e reconhecida no seu próprio aparelho. Nossa digitalização de 4 páginas e 8,07 MB precisou de 82,2 segundos. Uma digitalização de 100 páginas no celular pode levar minutos e parar se faltar memória.
Divida digitalizações longas em partes de 10 a 20 páginas com Dividir PDF, reconheça cada parte e junte os resultados com Juntar PDF. Mantenha a tela ligada e a aba em primeiro plano enquanto ela trabalha. Quando o pdf24 OCR não funciona por falta de memória, um notebook termina o mesmo arquivo muito mais rápido que um celular.
Nenhuma dessas soluções afeta a privacidade: o arquivo é lido com a File API e processado localmente, e os nossos registros de requisições mostraram 0 bytes enviados.
pdf24 OCR não funciona: perguntas frequentes
Por que o pdf24 OCR não funciona e diz que nenhum texto foi reconhecido?
O mecanismo não encontrou letras que conseguisse ler. Confira se o idioma corresponde ao documento, se a página está em pé e se a digitalização está nítida. No nosso teste, uma página reduzida para 330 × 467 pixels deu apenas 3 palavras, enquanto a digitalização em tamanho total deu cerca de 55 corretas.
O pdf24 OCR não funciona por causa do meu navegador?
Raramente. O OCR precisa de um navegador atual com WebAssembly e web workers, que o Chrome, o Edge, o Firefox e o Safari suportam. Versões muito antigas, ou extensões que bloqueiam workers ou scripts de cdn.jsdelivr.net, impedem o mecanismo de iniciar. Atualize o navegador ou teste uma janela anônima sem extensões.
O pdf24 OCR não funciona por causa de um firewall?
Pode ser. O mecanismo e os dados do idioma são baixados de cdn.jsdelivr.net na primeira vez. Filtros de empresas, escolas ou Wi-Fi público às vezes bloqueiam esse endereço, e o progresso fica em 0 %. Tente outra rede ou peça ao administrador para liberá-lo; o seu documento nunca é enviado a lugar nenhum.
Por que o pdf24 OCR não funciona com letra manuscrita?
O modelo de reconhecimento é treinado com letras impressas, então a letra cursiva normalmente produz palavras erradas ou nada. Letras de forma bem feitas às vezes funcionam. Não existe configuração que melhore o reconhecimento de manuscritos, então, para anotações curtas à mão, digitá-las é mais rápido do que corrigir o resultado.
Se o pdf24 OCR não funciona, o meu arquivo foi enviado e falhou?
Não. Nada é enviado em momento nenhum: o navegador abre o seu arquivo localmente e executa o reconhecimento na página. Nossos registros de requisições não mostraram nenhuma requisição POST. Só o mecanismo e os dados do idioma são baixados, e eles não contêm nada do seu documento.
Por que o pdf24 OCR não funciona direito com os acentos?
Os acentos saem errados quando o idioma selecionado é diferente do idioma do documento. O modelo do inglês não espera letras como é, ã ou ç, então as troca ou descarta. Escolha português, francês, alemão, espanhol, italiano, turco ou vietnamita conforme o texto e execute de novo.
Quanto tempo esperar antes de achar que o pdf24 OCR não funciona?
Espere cerca de 15 a 20 segundos por página digitalizada em um notebook, mais o primeiro download do mecanismo. Nossa digitalização de 5 páginas levou 75,1 segundos e a de 4 páginas pesadas, 82,2 segundos. Se o contador de páginas não se mexer por vários minutos, recarregue a página e teste um arquivo menor.
Girar as páginas resolve quando o pdf24 OCR não funciona?
Muitas vezes, sim. Páginas de lado e de cabeça para baixo dão pouco ou nenhum texto. Coloque-as em pé com Girar PDF, salve a nova cópia e aplique o OCR nela. Digitalizações mistas com apenas uma página girada são comuns, então confira cada página na prévia antes.
Por que o pdf24 OCR não funciona na foto de uma placa?
O OCR é feito para documentos: texto escuro sobre um fundo claro e plano. Fotos de placas, telas ou embalagens têm perspectiva, reflexos e fontes decorativas, que dão resultados ruins. Uma foto sem nenhum texto chegou a produzir cerca de 494 palavras de ruído no nosso teste.
O pdf24 OCR não funciona com texto em árabe?
O árabe é um dos 11 idiomas, então funciona quando o árabe está selecionado e a impressão está nítida. Fontes árabes pequenas, com pouco contraste ou decorativas reduzem a precisão, como em qualquer idioma. Use uma digitalização nítida a cerca de 300 dpi e confira o texto reconhecido com o original.
O pdf24 OCR não funciona da mesma forma em outros sites de OCR?
Não podemos falar por outros serviços. O pdf24tools é independente e não tem vínculo com a PDF24 nem com a Geek Software GmbH; este guia trata do nosso próprio OCR, que roda o mecanismo de código aberto Tesseract no seu navegador. As soluções aqui se baseiam nas nossas medições de 2 de novembro de 2026.
O pdf24 OCR não funciona com arquivos protegidos por senha?
Não. Um arquivo que exige senha para abrir para com uma mensagem pedindo que você a remova. Use Desbloquear PDF com a senha que você conhece e depois aplique o OCR na cópia desbloqueada. Arquivos que só têm limites de impressão ou cópia são desbloqueados sem senha.
O que fazer se o pdf24 OCR não funciona mesmo depois de todas as soluções?
Teste a saída de texto em vez do PDF para ver o que o mecanismo realmente lê, teste uma única página limpa e use um notebook em vez de um celular. Se uma página limpa, em pé, de 300 dpi e no idioma certo ainda falhar, escreva para nós pela página de contato com uma descrição do arquivo.
Mais ferramentas e guias de pdf24 OCR não funciona
pdf24 OCR não funciona: fontes
- Optical character recognition — Wikipedia
- Image resolution — Wikipedia
- Tesseract (software) — Wikipedia
- File API — MDN Web Docs